Model
空
GPT Image 2.5 AI画像ジェネレーター
シンプルなテキストプロンプトやラフな下書きを、クリーンで商業的に適したビジュアル資産へと変換します。クリエイター、マーケター、そして複雑なプロンプトエンジニアリングを習得せずに精密なコントロールが必要なチーム向けに設計されたGPT Image 2.5では、ローカライズされた細部を修正したり、画像内の文字を鮮明に表示したり、あらゆるクリエイティブな段階において完全なキャラクターの一貫性を保つことができます。
GPT Image 2.5 の特徴
ピクセル単位の精度、非破壊編集、およびプロンプトの推測を一切必要としないクリエイターのワークフローに最適化されています。
スマートシーンコントロール
新しい編集をリアルな照明、影、奥行きとスムーズに融合します。
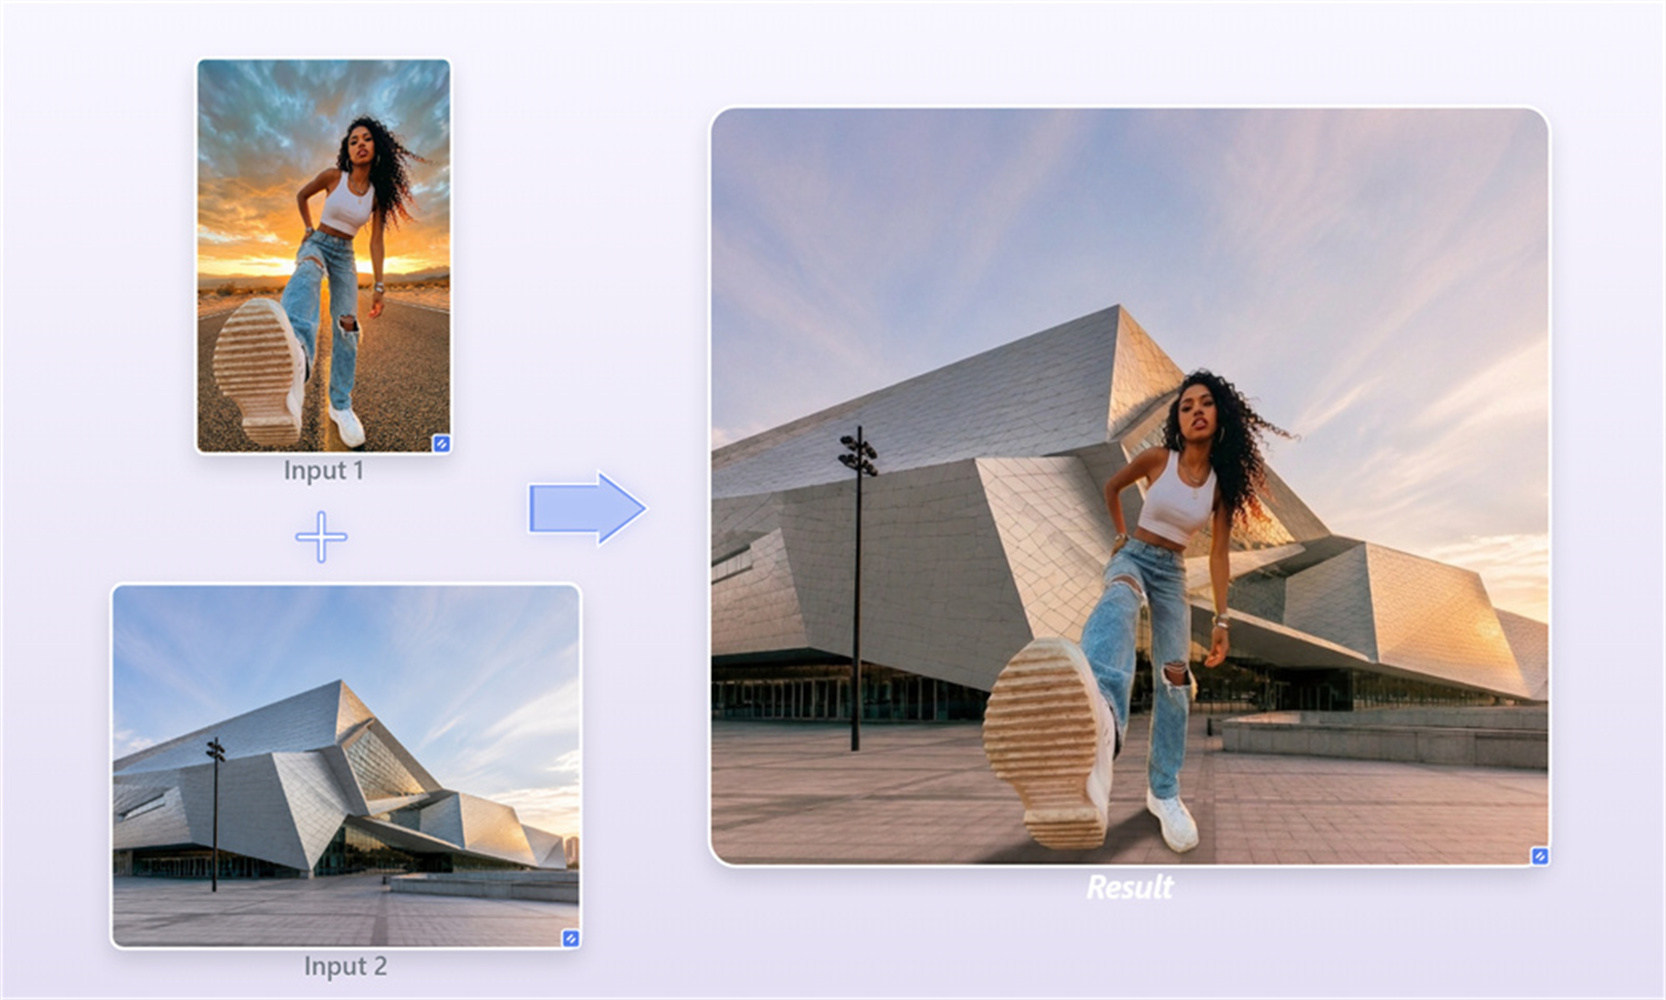
マルチリファレンス融合
最大16枚の画像をシームレスにマージし、視覚的品質を損なうことなく結合できます。
ネイティブアルファマスキング
透明なレイヤーにクリーンな切り抜きをエクスポートし、迅速なグラフィック作業を行いましょう。
低再ロール摩擦
複雑な視覚的な指示を最初の試行で正確に追って、時間を節約しましょう。
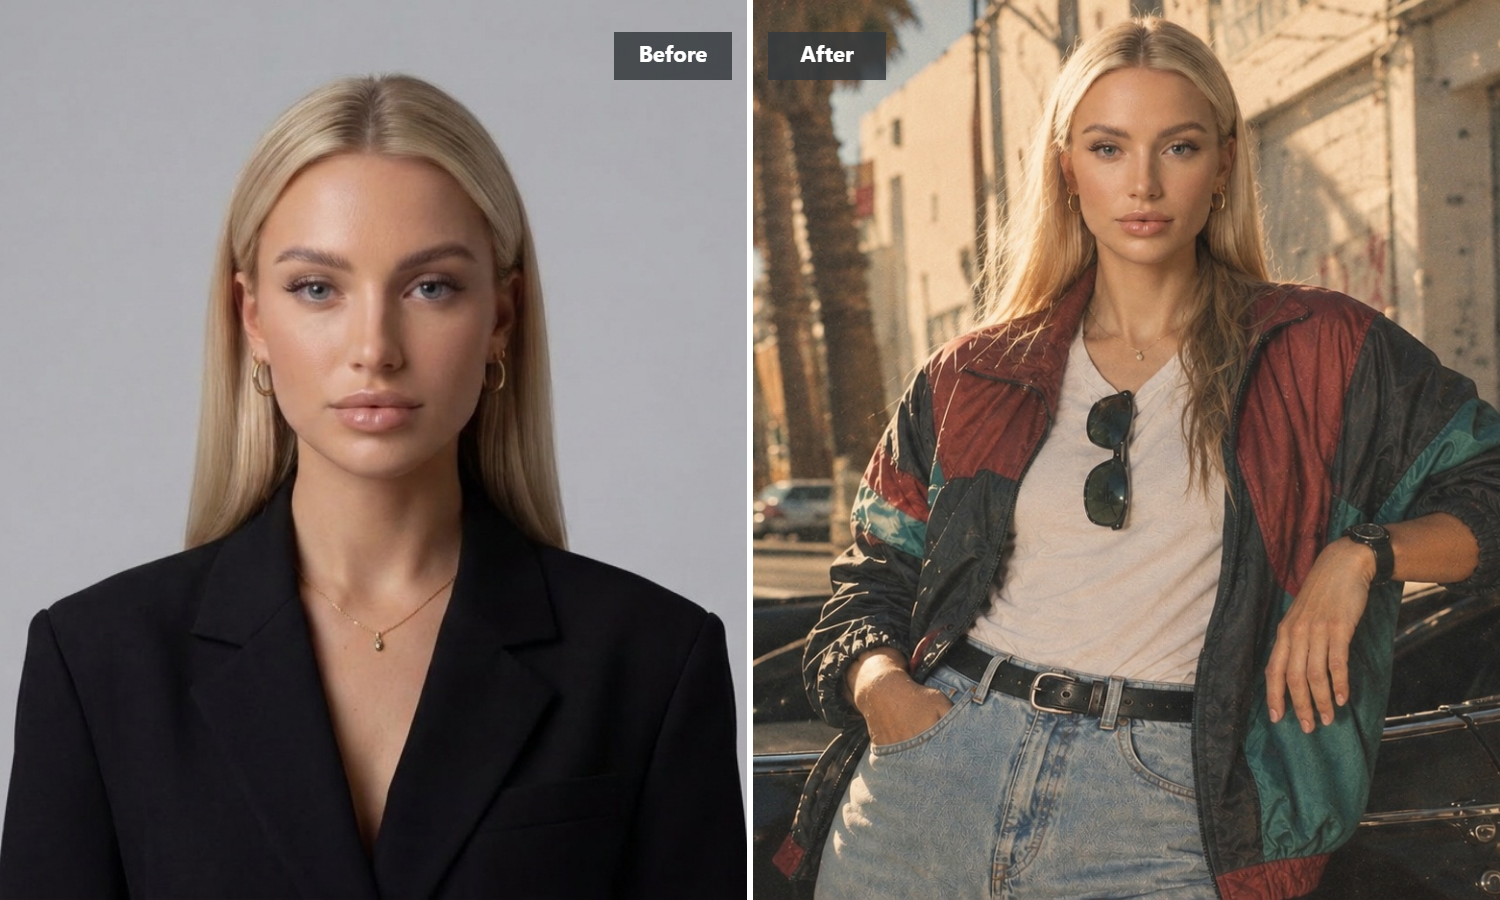
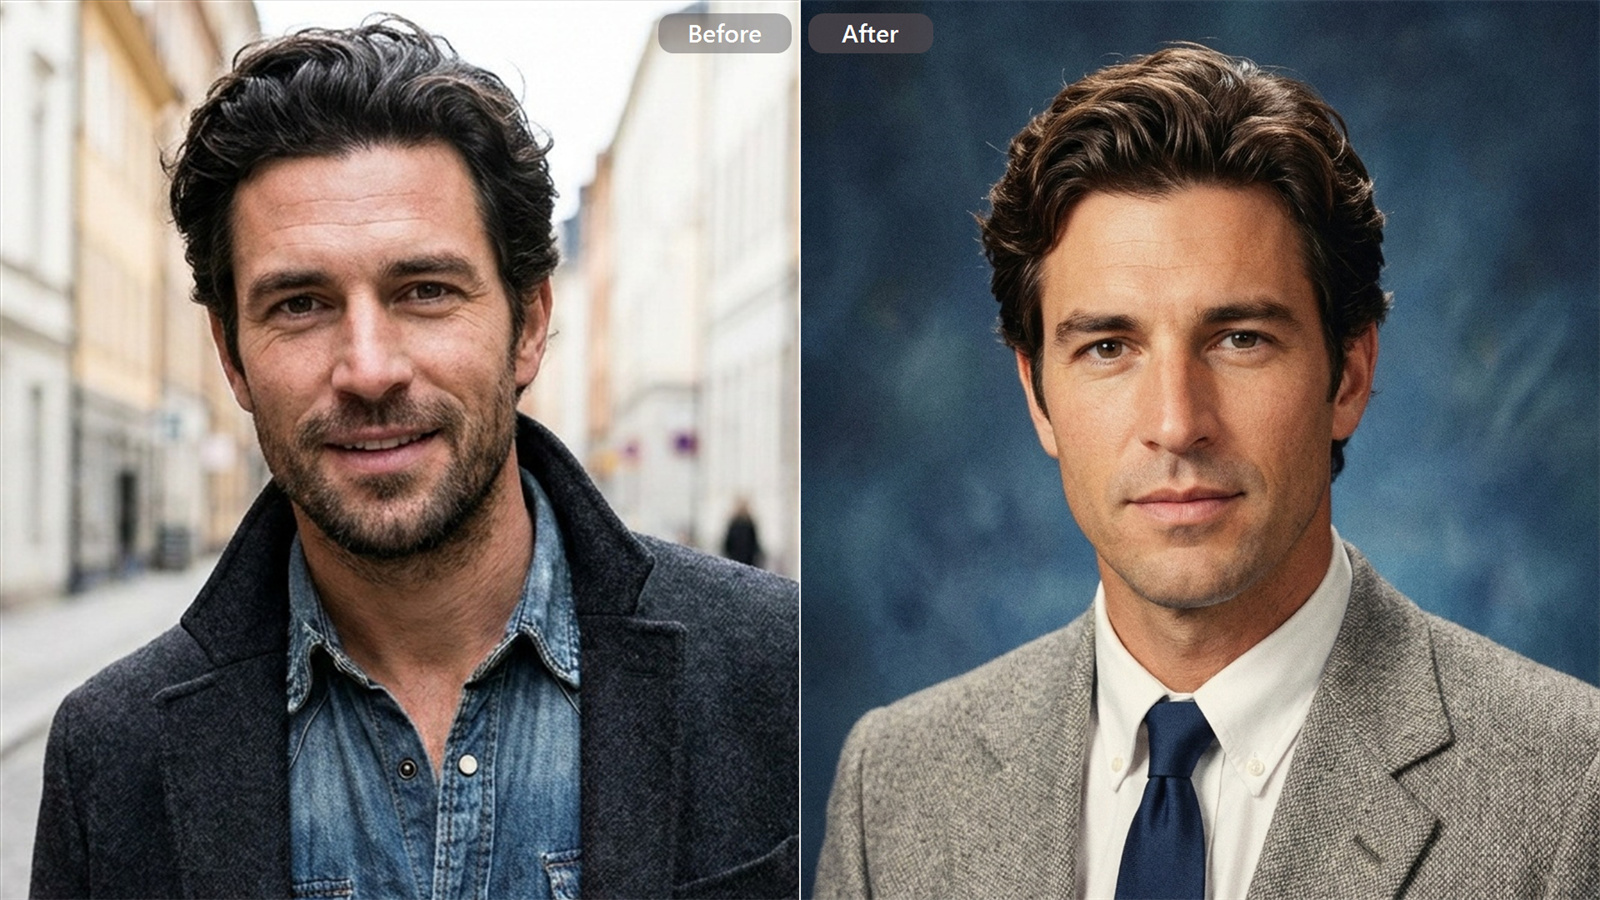
すべてのシーンで同じキャラクターを維持する
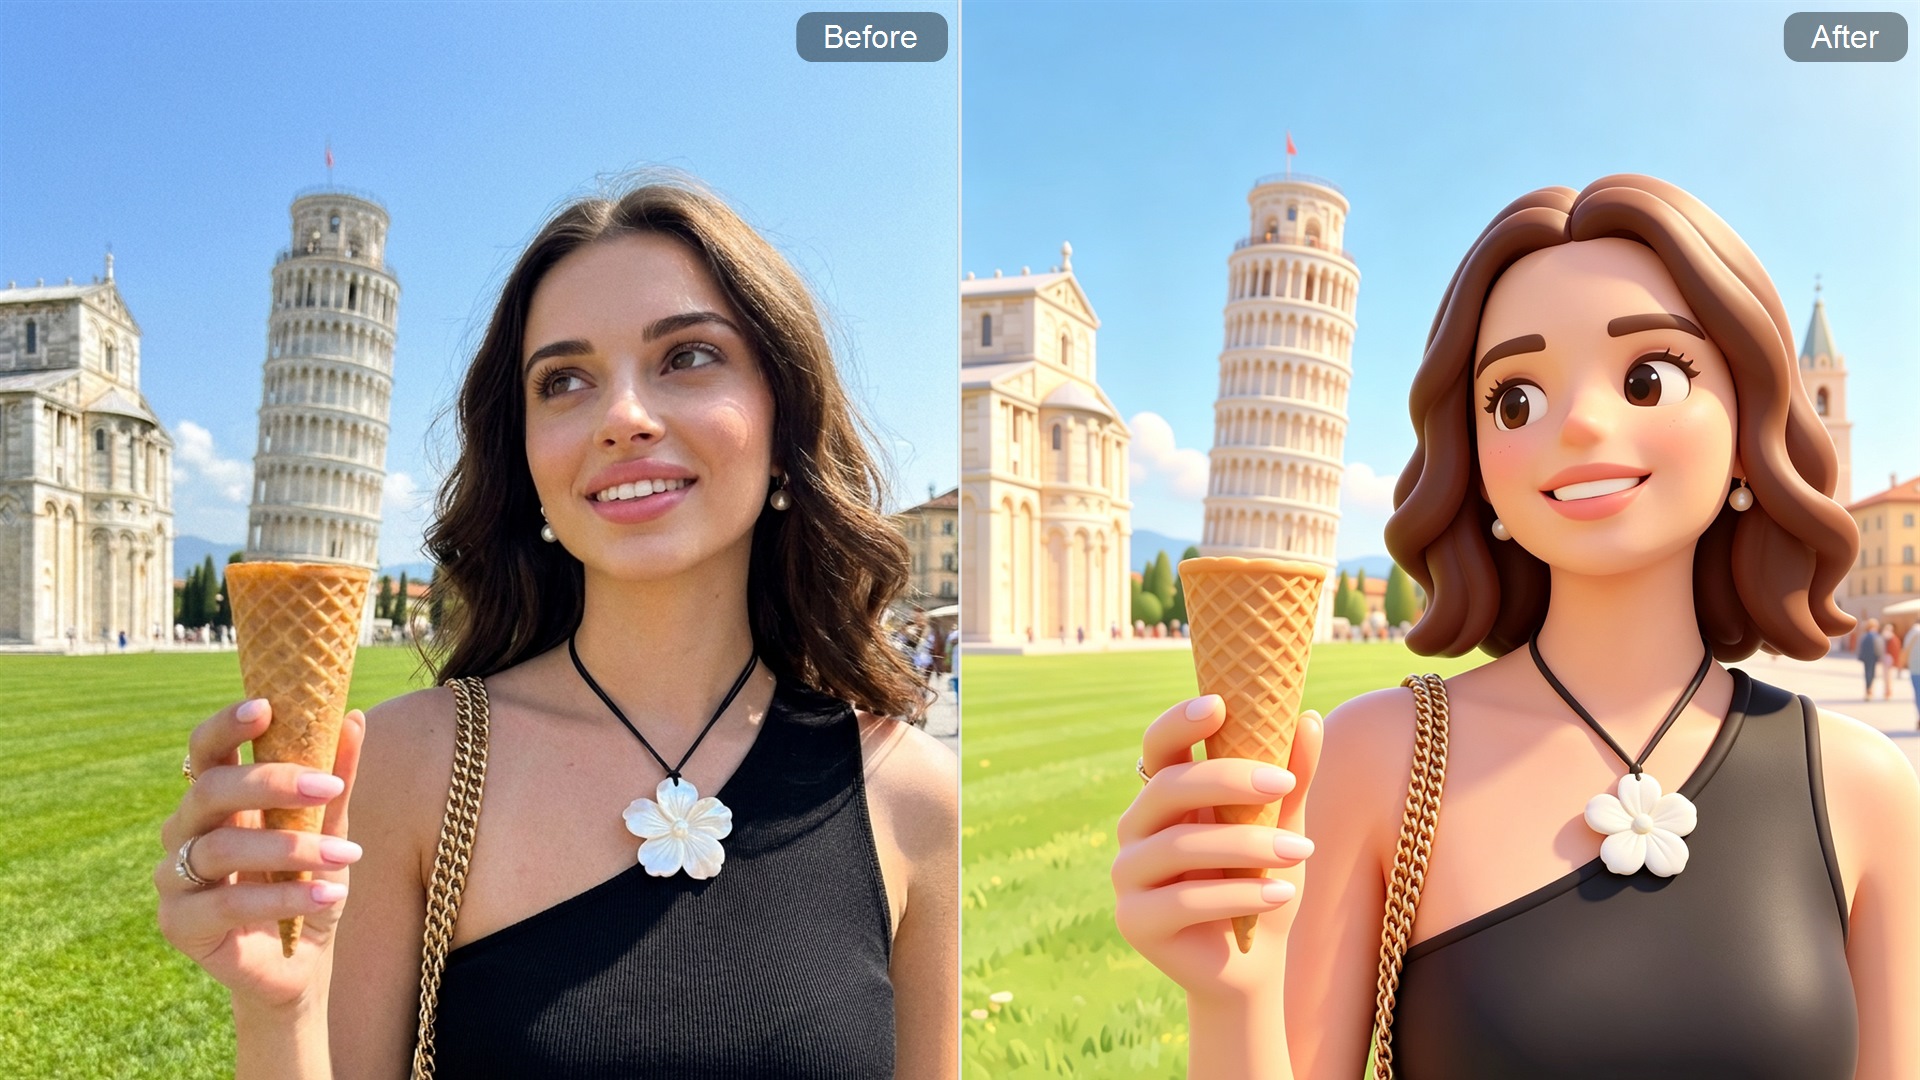
プロンプトを調整しても、毎回まったく異なる顔になることはありません。このモデルは、複数のクリエイティブなイテレーションにわたって顔の構造、髪型、服装を固定します。シーンを変更したり、カメラアングルを傾けたり、背景の照明を変えたりしても、コアとなる被写体がショットごとに完全に識別できるようにしてください。
最初からやり直さずに、具体的な詳細を微調整する
小さな領域をハイライトして、小さなアイテムを交換したり、不要な欠点を修正したりできます。エディターは選択した箇所のみを更新し、作品の他の部分には一切手を加えず、影や周囲の光を自然に融合させます。
視覚コンテンツの中に読みやすいテキストを直接追加しましょう
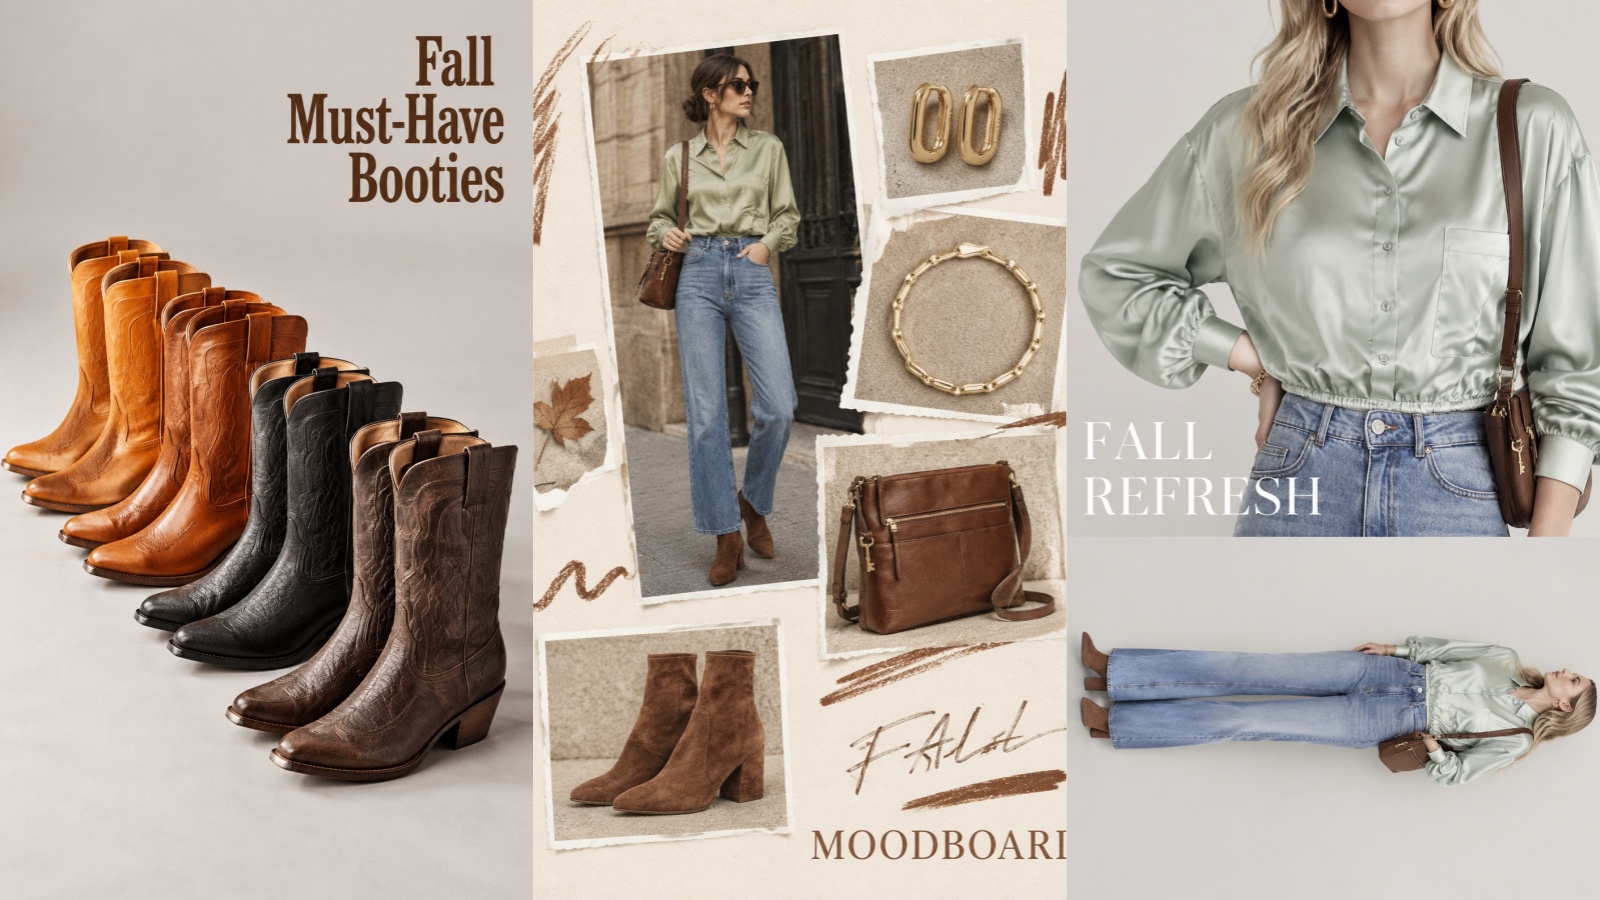
読みやすい文字、クリーンなラベル、鮮明なロゴを、見出しテキストを入力するためにわざわざ二次的なデザインソフトに移動することなく、そのままポスターやパッケージのコンセプトに配置できます。
迅速な視覚的フィードバックでより速い編集を実現
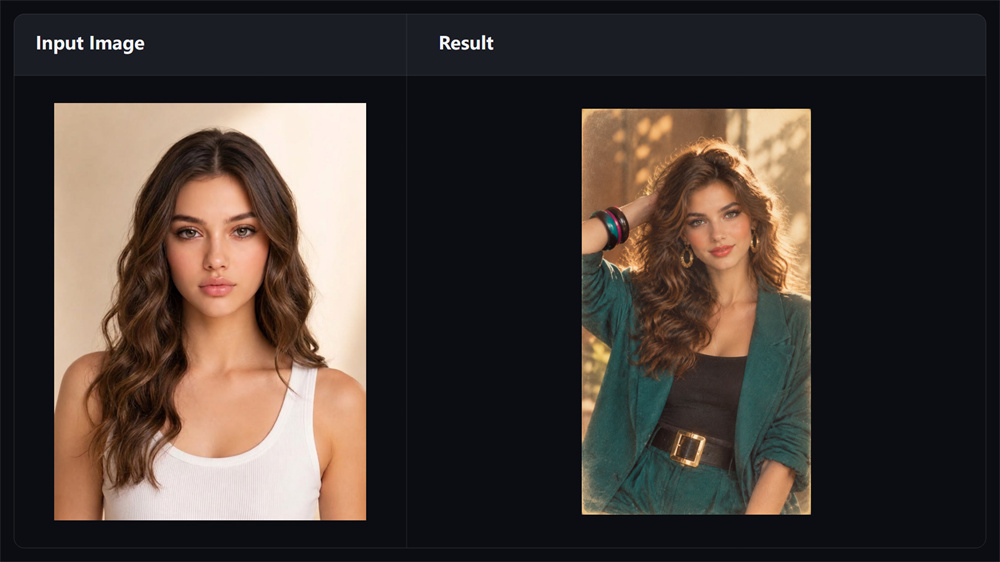
アクティブな編集に最適化されたレンダリングの応答性により、クライアントのアイデアをテストしたり、コンセプトを繰り返し検討したり、マーケティンググラフィックスを磨いたりする際に、即座に視覚的なフィードバックが得られ、クリエイティブな流れをスムーズに保つことができます。
クリエイティブなプロンプトのインスピレーションとビジュアルスタイルのアイデア
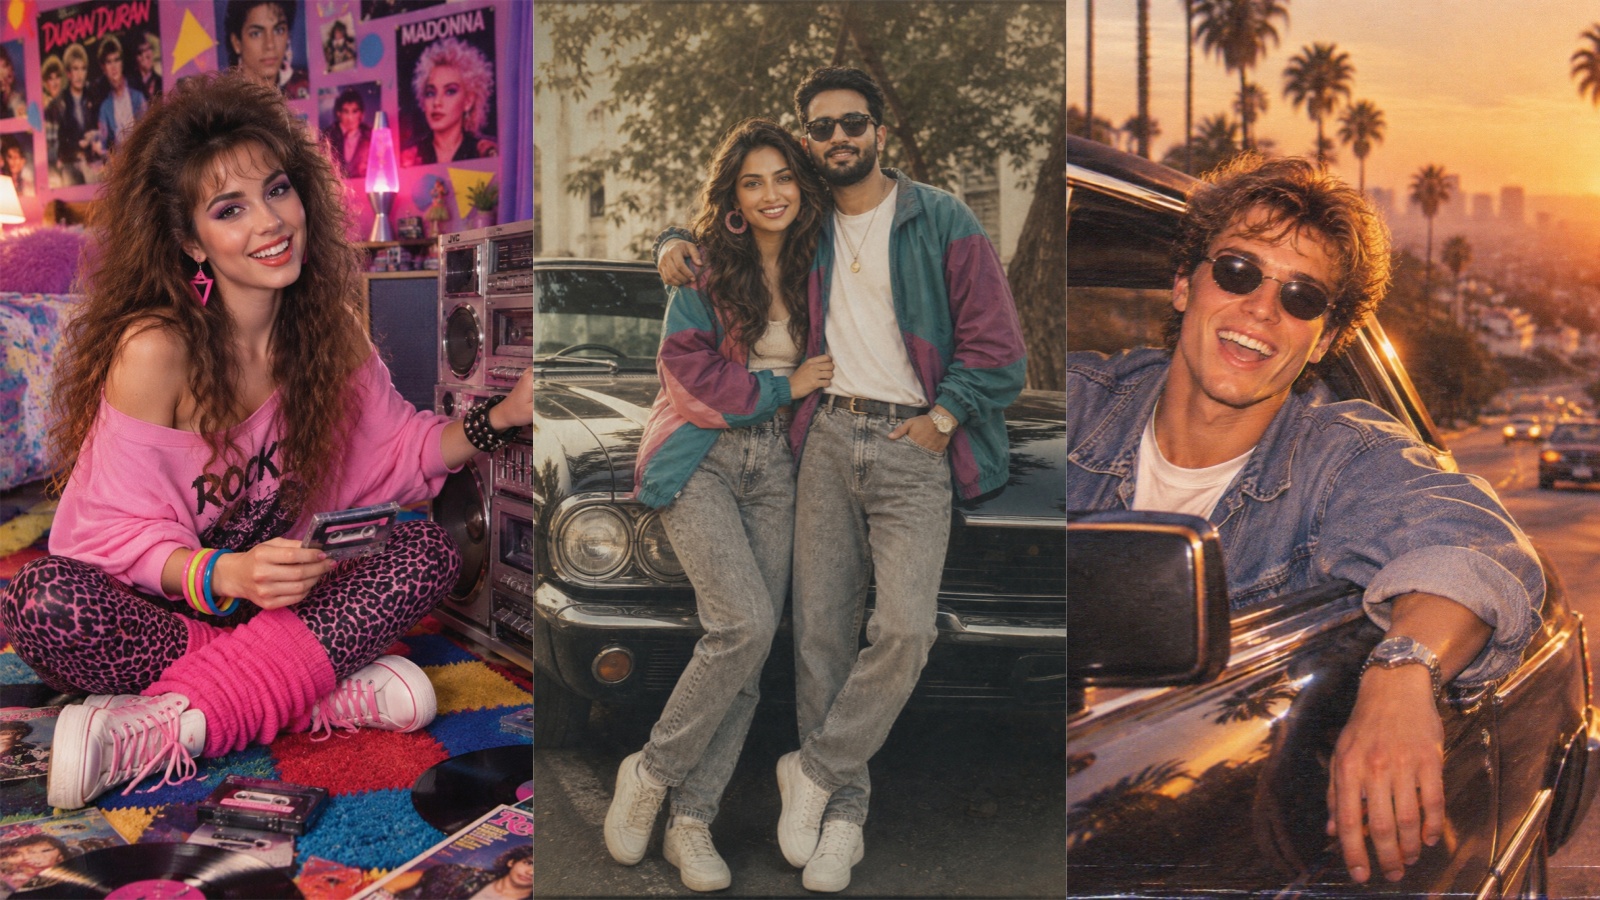
何を書けばいいか迷っていますか?Gumaで厳選されたビジュアル例をご覧ください。すぐに使えるスタイルのアイデアや視覚的なヒントを見つけて、さっと得たインスピレーションを完成したアート作品に仕上げましょう。
ビジュアルの作成と編集方法
あなたの入力コンテンツを追加してください
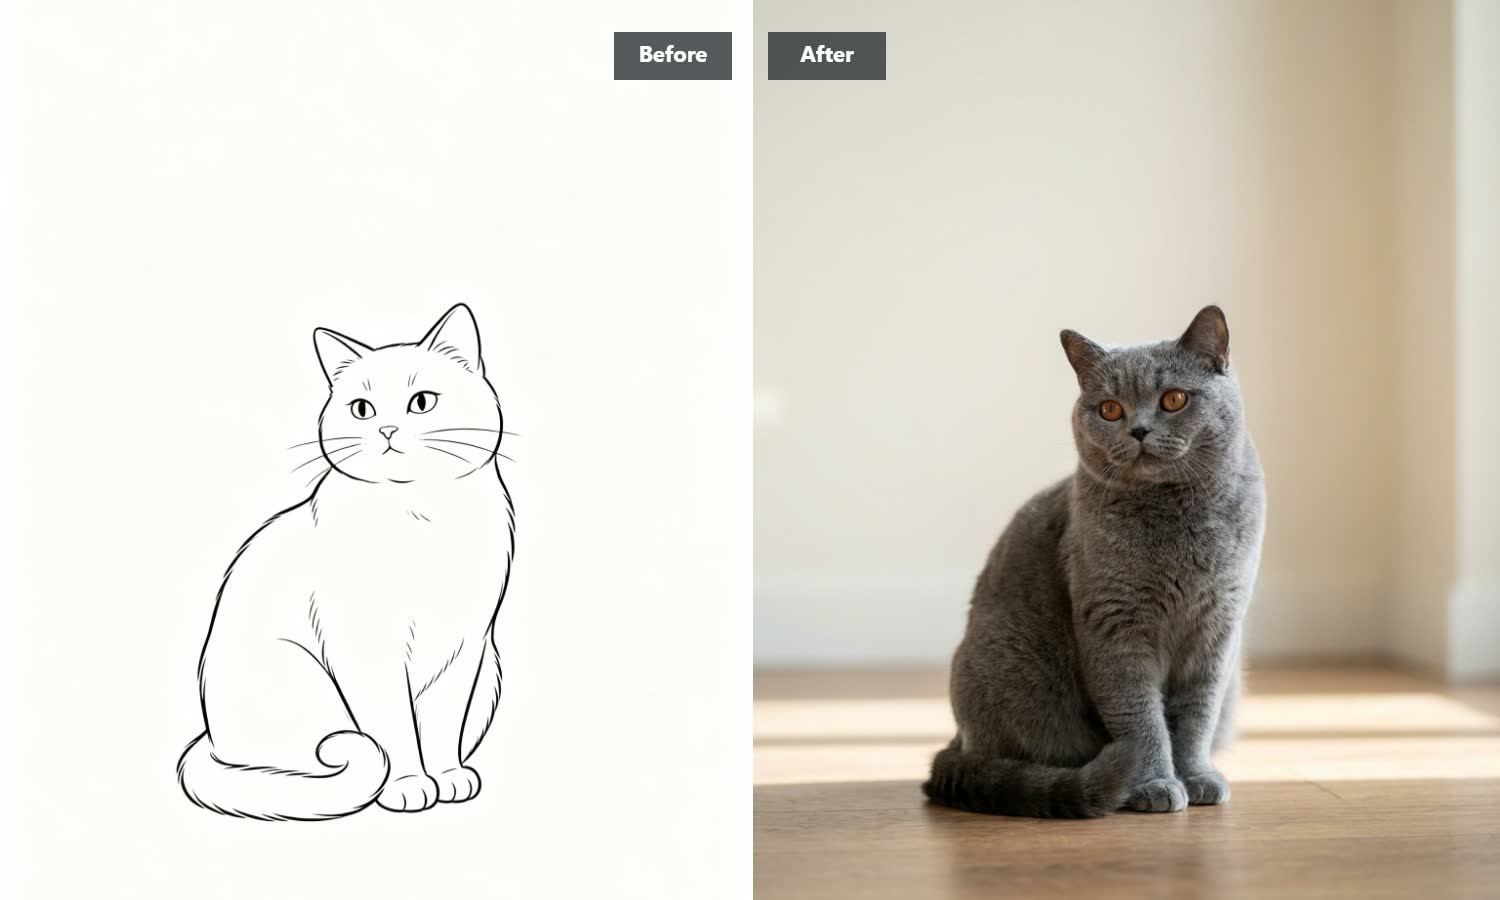
詳細なテキストプロンプトを入力するか、または参考画像のサンプルをアップロードして生成をガイドしてください。
画像を生成してエクスポートする
「生成」をクリックし、必要に応じて特定の領域を微調整してから、レンダリングが完了次第、高解像度のPNGまたはJPGファイルをダウンロードしてください。
その他の GPT Image 2.5 モデルを見る
AI画像・動画作成ツールをさらに探る
よくある質問
なぜGPT Image 2.5を使うためにGumaを選ぶのですか?
Gumaは、GPT Image 2.5の強力な生成力をシンプルでエディターに優しいインターフェースと組み合わせています。ローカルなインペイントツールへの直接アクセス、直感的な複数ターンのキャラクター追跡機能、そして複雑なメニューを飛び越えることなくスムーズなエクスポートワークフローをご利用いただけます。
GPT Image 2.5が古い画像モデルと異なる点は何ですか?
最大のアップグレードは、速度と制御です。ジェネレーションの処理速度が大幅に向上し、キャラクターは連続した編集でも一貫して同じまま保たれ、テキストは画像内でも明確に表示され、奇妙なスペルミスもありません。
複数のプロンプト間でキャラクター編集はどのように機能しますか?
このモデルは、顔の形や服の質感、ブランド要素などの主な視覚的アンカーを記憶しています。変更をリクエストすると、必要な部分だけを更新し、核心となる被写体はそのまま残します。
製品グラフィックスの背景要素を削除できますか?
はい。背景と被写体を明確に分離した被写体を生成できるため、ウェブショップやセールスデッキで製品や孤立したグラフィックを透明な背景に簡単に配置できます。
ターゲットにした写真編集はどのくらい正確ですか?
シャツの色を変更したり、影を追加したり、小道具を交換したりと、周囲のテクスチャを歪めることなく、また周囲の照明を変えることなく、正確な箇所を選んで編集できます。