生まれた
生まれたで同じスタイルを簡単に再現
生まれたのプロンプトをワンクリックでコピーし、ゼロから作り直すことなく画像や動画で同じスタイルをすばやく再現できます。
AIプロンプト
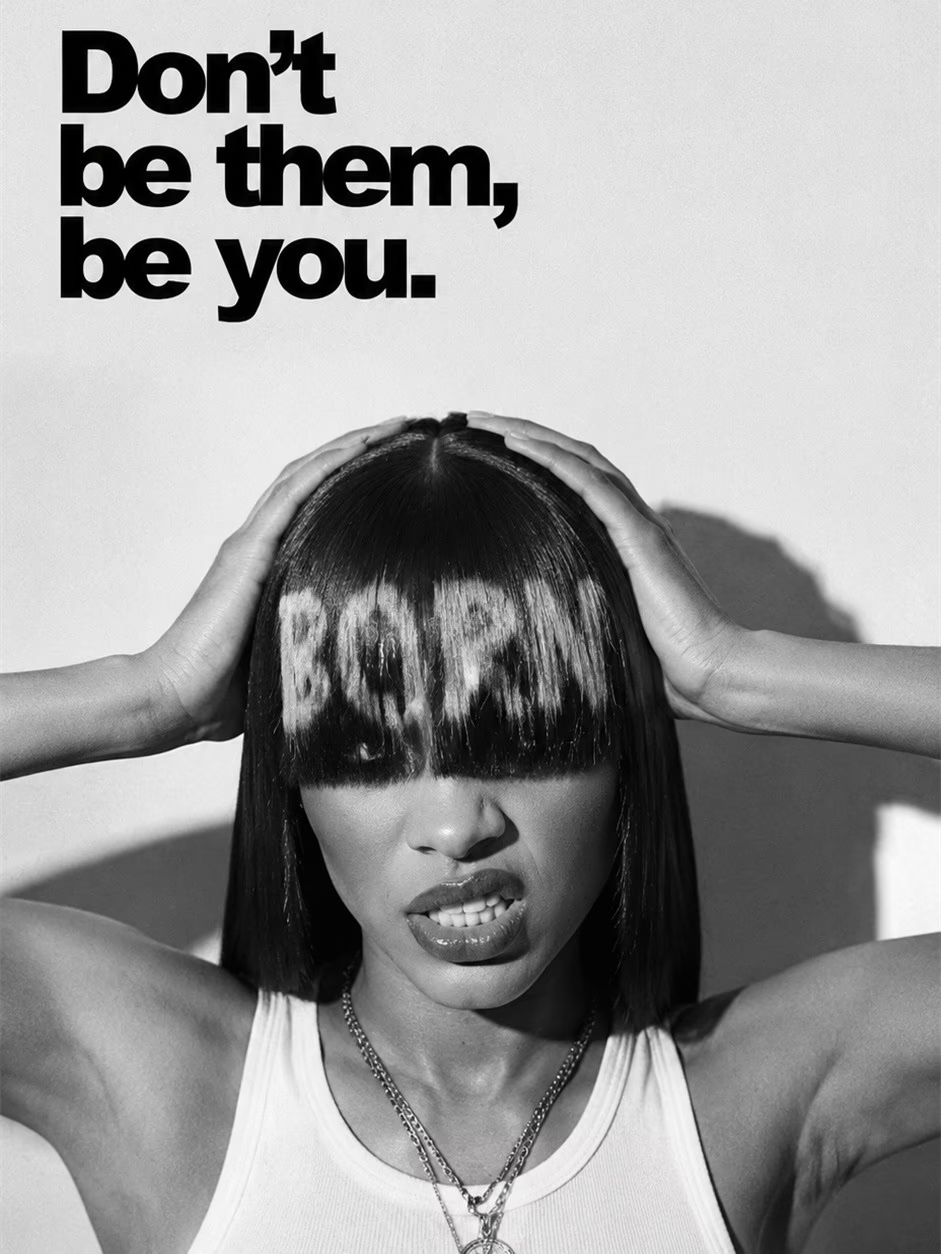
リアルなポートレート、モノクロ調、{ノイズ:3.0}、{原画像における主人公の主要な顔貌特徴を参考:1.6}。 白黒の高コントラストが際立つスタイリッシュなポートレート。主人公は正面を向いてカメラを見据え、両手を頭上に挙げて頭頂部を押さえ、両腕を左右へ大きく広げて伸ばし、やや前傾姿勢を取る。背景は淡い白色の壁面で、明確な斜めの濃色の陰影が配され、全体として反逆的で個性的、ストリートマガジンのような雰囲気と自己表現の感覚を演出している。 衣装:主人公は純白のフィットするノースリーブタンクトップを着用。丸首デザインで素材はシンプルかつ洗練され、上半身の輪郭にぴったりと沿い、肩、鎖骨、腕のラインを際立たせている。デザインには目立った模様はなく、全体的にミニマルでスポーティーかつストリートなスタイルだ。 シーン:背景は淡い白色の無地の壁面で、複雑な環境の小物や装飾は一切ない。人物の背後には斜めに伸びる濃色の陰影が現れ、画面に奥行きとドラマチックな緊張感を加えている。画面上部の文字は主に黒色の太字スローガンで、三行に配置されている:「Don’t」「be them」「be you」。重厚でインパクトのあるサンセリフの太字を使用し、字体はArial BlackやHelvetica Neue Heavyに近い。筆画は太く、字面は広く、字間は詰まっており、黒い文字は強い視覚的重量を持つ。三行はきっちりと並べられ、左揃えでまとまった矩形の塊を形成している。全体として、高コントラストで若々しく個性的なストリート系のビジュアルデザインだ。なお、画面上部の文字の上には必ず明確な余白を確保し、上端ギリギリに寄せたり、画面の上部を埋め尽くしたりしないよう注意する。トップと一行目の文字との間には、十分な幅の背景スペースを残すことが重要である。 ポーズ:人物は正面を向いて立ち、両手を頭上両側に置き、指は自然に開いて髪にそっと添える。両肘は外側へ広げられる。両腕は画面の左右端から伸び、開放的な三角構図を形成している。頭部は顕著に前方へ傾き、あごを軽く引いた状態。前髪が目にかかって目元を隠し、唇はわずかに左右へ引き延ばされながら下方向へ押し下げられ、口元には緊張感と軽く歯を噛むような反逆的な表情が浮かぶ。上唇は少し持ち上げられ、上下の歯が覗くことで、冷厳で反逆的、そして神秘的で自信に満ちた印象を与える。 メイク・アクセサリー:全体的に白黒写真ならではのクールなトーンのメイクで、ハイライトとシャドウのコントラストが際立つ。目の上には分厚い前髪が大きく覆いかぶさっている。前髪の中央には白く漂白された「BORN」という文字が施されており、これは一部の毛束を漂白して白く染めたヘアデザインで、文字はスプレー塗料や印刷、後加工によるものではなく、生え際の毛髪そのものと一体となっている。各文字は実際の毛束で構成され、髪のカーブや垂れ具合に沿って変化し、縁は柔らかく不規則で、部分的には黒い毛や髪の分け目によって遮られている。明暗の濃淡が入り混じり、毛髪の質感やほつれ、自然な光沢も残されている。根元には濃い色の毛先が繋がる遷移もあり、全体としてまるで漂白やハイライトで作られた文字パターンのようだ。眉や目元のディテールは控えめに見え隠れし、唇の色はやや濃く、微開した口元の中で歯が際立つ。銀色や金属感のある多層ネックレスを着用し、中央には円形のバッジ型ペンダントと鍵型ペンダントが配され、白いタンクトップに垂れ下がるネックレスが視覚的焦点となる。 フレームサイズ:縦位置のクローズアップポートレート。画面は頭部から肩・首の上部まで広がり、両腕は左右の画面端を超えて伸びる。人物は画面の最下部に位置し、頭部・両手・ネックレスが縦方向の視覚的軸を形成している。文字は人物の頭上およびその上の領域に配置される。 照明:強烈で硬質な斜め上方からの光、あるいは指向性のスタジオライトを用い、高いコントラストの白黒効果を生み出す。顔の中央部やタンクトップのエリアは明るく、髪や前髪、背景の陰影はより濃く、人物の背後の斜めの陰影が立体感とドラマティックな雰囲気を一層強める。全体として、冷厳で鋭く、モダンな光の演出が施されている。 撮影アングル:正面からのアイレベルの視点。カメラと人物の目はほぼ同じ高さにあり、やや近接した撮影により、顔や手の動き、肩・腕のライン、ネックレスの細部を際立たせる。俯瞰や仰角のアングルは一切使わず、直接的で強烈、衝撃的な視覚的コミュニケーションを強調している。 {原画像における主人公の主要な顔貌特徴や性別、髪色・髪型、生物的特徴は変更せず}、{リアル度:1.6}、人体のプロポーションは正確に再現されている。